Technik
Wie ein Spiel entsteht, das fast niemand von Hand programmiert: das Schichtsystem, die Prüfteams, die Grafik- und Ton-Pipelines – und der Friedhof der Ansätze, die nicht funktioniert haben.
Wer was macht
Jens schreibt kein Programm. Er hat am 6. Oktober ein Startpaket ins Repository gelegt – Konzept, Regeln, Rollen, rund 110 Arbeitspakete – und steuert seitdem über ein einziges Dokument, das Steuerpult. Dort stehen Modus, Wochenbudget, erlaubte Schichten und seine Notizen. Dazu kommen fünf Tore, an denen er das Spiel selbst auf dem iPhone prüft, und die Freigaben für teure Grafik-Läufe.
Alles andere macht Claude: planen, programmieren, testen, prüfen, Grafik und Ton erzeugen, Fehler suchen, Entscheidungen dokumentieren. Von 2.285 Commits stammen 2.240 von der KI. Die 45 von Jens sind fast alle Häkchen und Notizen.
Der Schichtbetrieb
Eine geplante Cloud-Routine startet stündlich eine neue Claude-Code-Sitzung. Deren erster Befehl entscheidet, ob überhaupt gearbeitet wird: Steht das Steuerpult auf Pause, läuft schon eine Schicht oder ist das Wochenlimit erreicht, endet die Sitzung sofort und ohne Commit.
Darf sie arbeiten, wird sie zum Leiter. Sie liest den Stand, wählt Pakete, reserviert sie und schickt Bauteams los – Subagenten mit eigener Arbeitskopie und eigenem Branch. Jedes Team pusht nach jedem Commit. Fertig ist ein Paket erst, wenn ein anderer Agent es geprüft hat, die Tests grün sind und jemand den Screenshot im Handy-Format angesehen hat. Auf main integriert nur der Leiter. Ab Minute 170 fängt er nichts Neues mehr an.
Gedächtnis aus Dateien
Keine Sitzung erinnert sich an die vorige. Was zählt, steht im Repository: der Status mit allen offenen Punkten für Jens, das Schichtprotokoll, die Paketliste mit 395 Einträgen, deren Titel und Abnahmekriterien niemand ändern darf, und das Entscheidungslog mit inzwischen 198 Einträgen. Eine neue Schicht liest das, und weiß dann so viel wie die letzte.
Sechzehn Rollen
Architekt, Engine, Kampf, Welt, Oberfläche, Server, Grafik, Audio, Balancing – dazu die Prüfteams Tester, Bugjäger, Spielbarkeit, Architektur-Review und Security, und zwei kleine Helfer fürs Suchen und Logs-Lesen. Seit dem 20. Oktober arbeiten die Kernteams mit Opus, Grafik, Audio und Balancing mit Sonnet, die Helfer mit Haiku.
Budget als Regel
Jede Kasse hat ein Kostenbuch und eine harte Sperre im Werkzeug: das Claude-Kontingent über die Zahl erlaubter Schichten pro Woche, die Bildgenerierung über einen Deckel und Freigaben je Antrag, ElevenLabs über eine Monatsgrenze mit Bremse je Lauf. Eine Schicht verbraucht gemessen etwa 2 bis 3 Prozent des Wochenkontingents.
Wie geprüft wird
Erst Tests, dann Code, und Tests werden nie abgeschwächt, um grün zu werden. Rund die Hälfte aller Codezeilen im Projekt sind Tests. Bauteams prüfen nur, was sie berührt haben; den vollen Integrationslauf fährt nur der Leiter. Klicktests laufen im Handy-Querformat für iPhone 16 und Pixel 7.
Kleine Reviews und alle Security-Prüfungen laufen über einen eigenen Weg mit dem API-Guthaben. Gleich der erste Probelauf fand einen schweren Fehler beim Speichern, den das normale Review übersehen hatte. Nach jeder Phase mit Tor gibt es eine Prüfwelle mit fünf Prüfteams.
Ehrliche Zahlen
Von 3.356 erfassten Testläufen waren rund ein Viertel rot. Im Schnitt hat eine Schicht 33 Werkzeugfehler. Das steht hier, weil es dazugehört: autonome Entwicklung ist kein gerader Weg, sondern viele kleine Korrekturschleifen.
Wenn die Maschine sich selbst im Weg steht
Am 17. Oktober liefen bis zu vier Bauteams gleichzeitig auf einem Container mit vier Kernen. Die Last lag bei 15 bis 30, Tests wurden nur noch durch Zeitüberschreitung rot, und eine Schicht brauchte 254 Minuten für ein einziges integriertes Paket. Der Leistungstest maß im Container ohne Grafikkarte vor allem die Maschine: derselbe Code lag mal bei 8, mal bei 119 Millisekunden pro Bild.
Jens ließ die KI 15 Schichten analysieren und extern recherchieren. Daraus wurde der Umbau H1 bis H10: Leistung wird jetzt auf vier Ebenen gemessen statt per Stoppuhr, schwere Läufe brauchen einen freien Rechenplatz, Klicktests laufen einzeln, Standard sind zwei Teams. Ein anderer Software-Renderer im Container senkte die Bildzeit der Testszene von 150 auf 17 Millisekunden.
Grafik ohne Zeichner
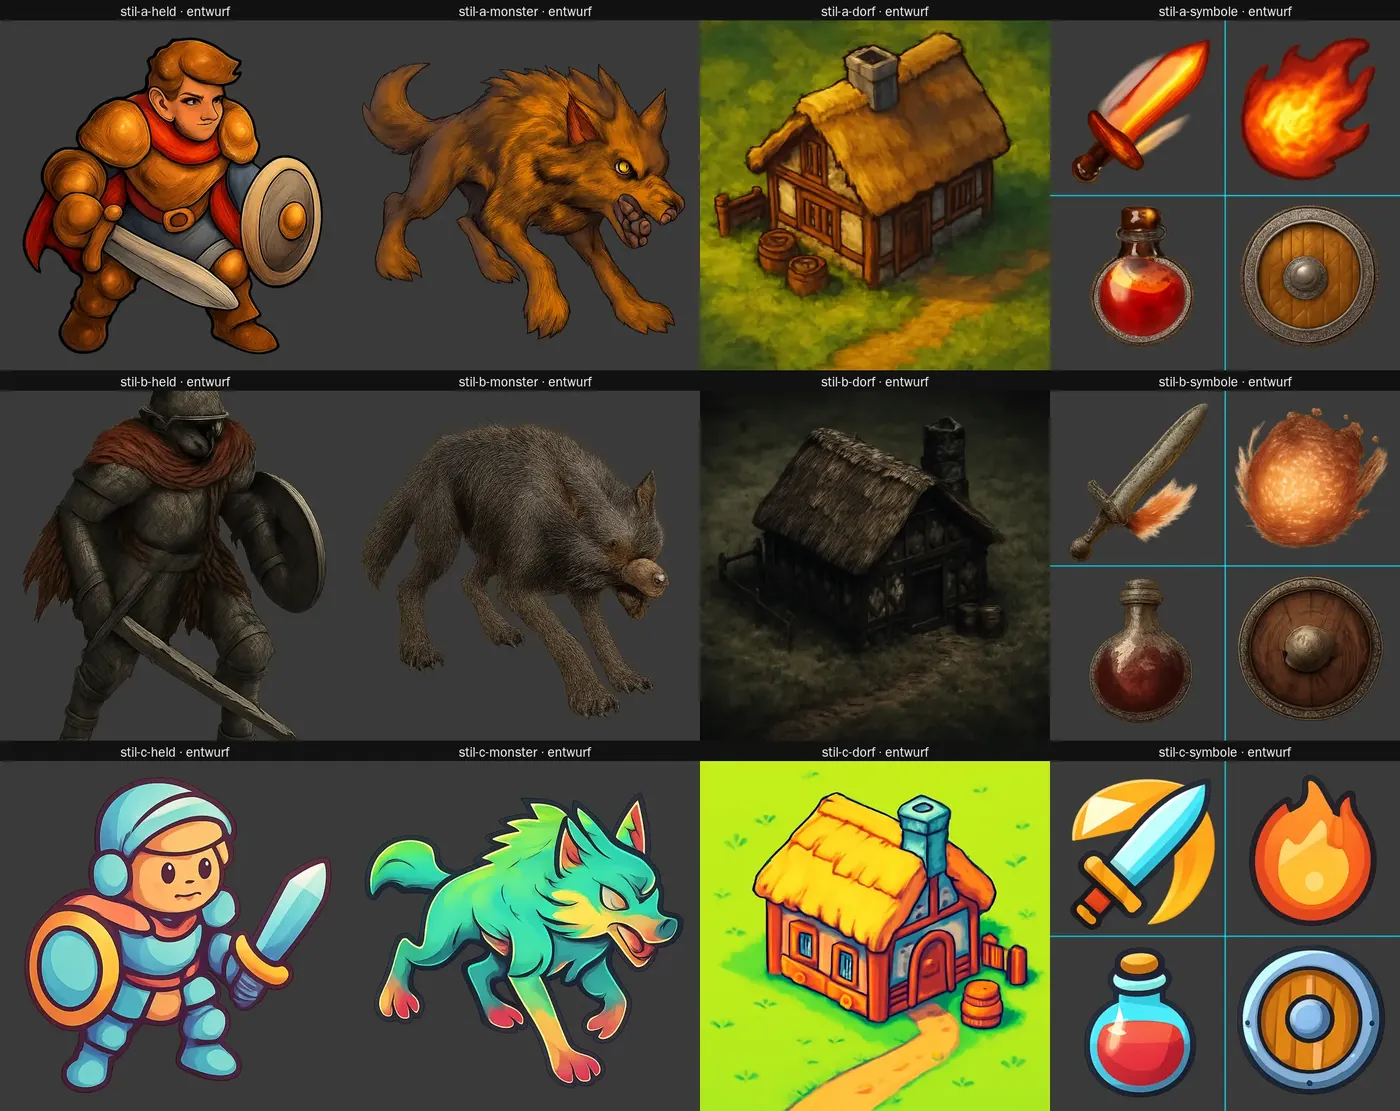
Alle Bilder entstehen über OpenAI-Bildmodelle. Jeder Auftrag beginnt mit demselben wörtlichen Stilpräfix: handgemalt, warme Grün- und Goldtöne, dicke dunkle Kontur, Blick von etwa 55 Grad schräg oben, Licht von links oben. Spielenamen und Marken sind im Prompt verboten; das Werkzeug lehnt sie ab.
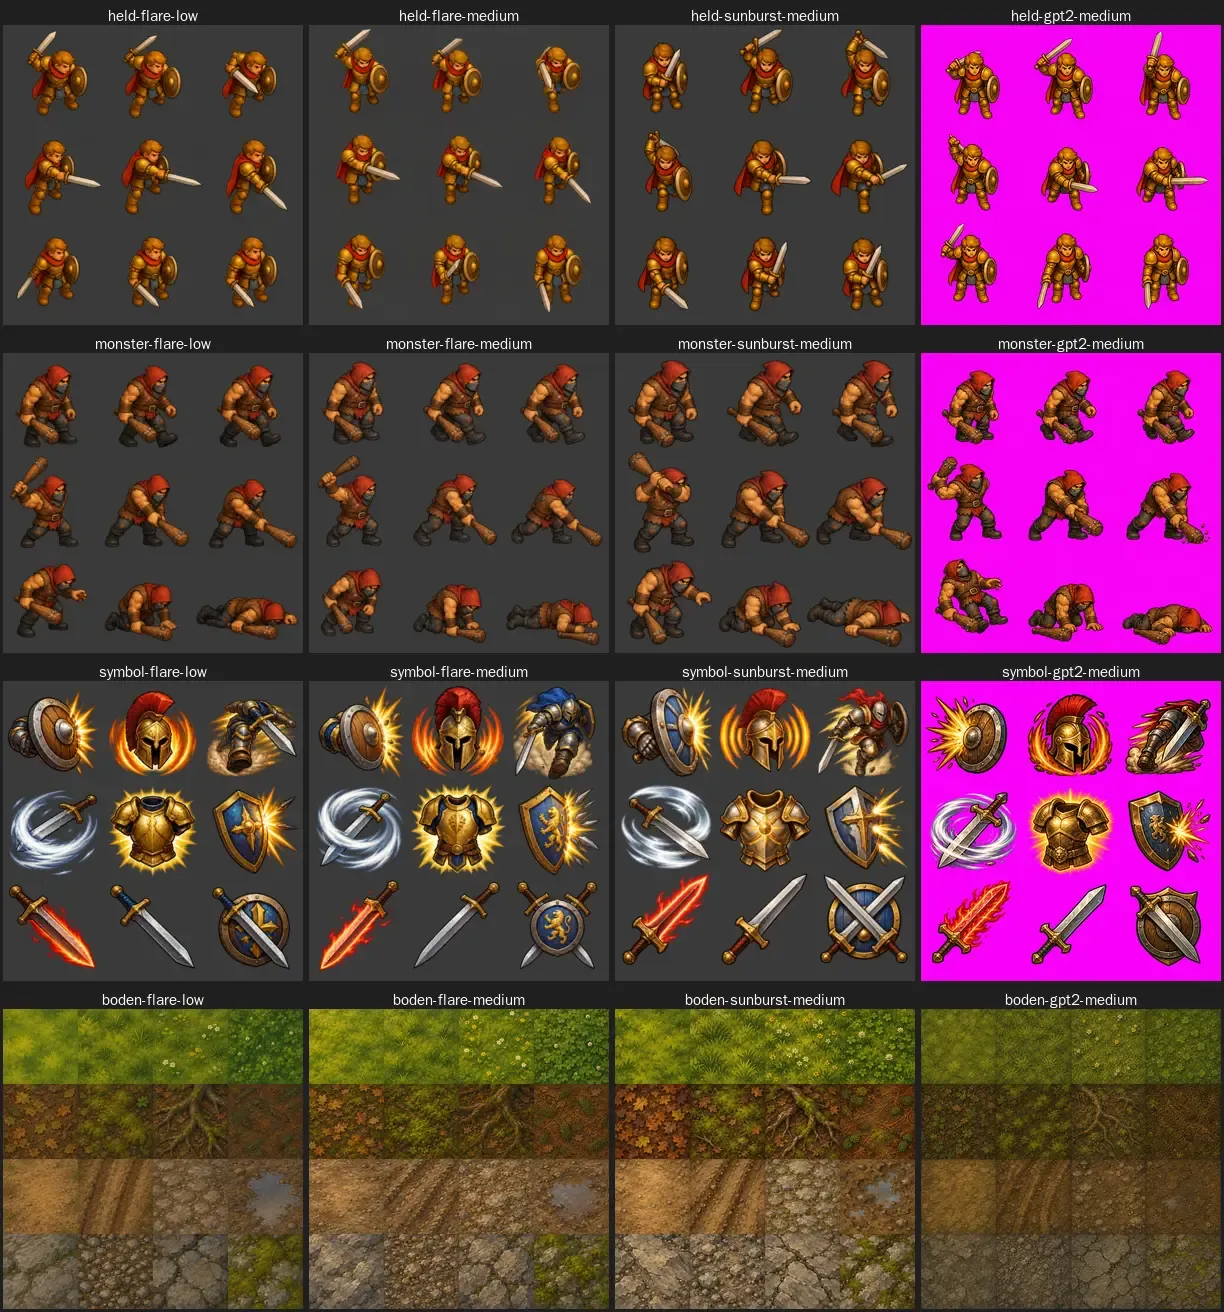
Entwürfe sind billig und laufen ohne Rückfrage. Finale Bilder kosten mehr und brauchen einen Antrag mit Kontaktbogen, den Jens per Häkchen freigibt. Danach prüft Claude Sonnet jede einzelne Zelle gegen eine Referenz und sortiert in ok, nachbessern, verwerfen. Bis heute: 718 Bildanfragen, davon 279 finale.
Das Laufproblem
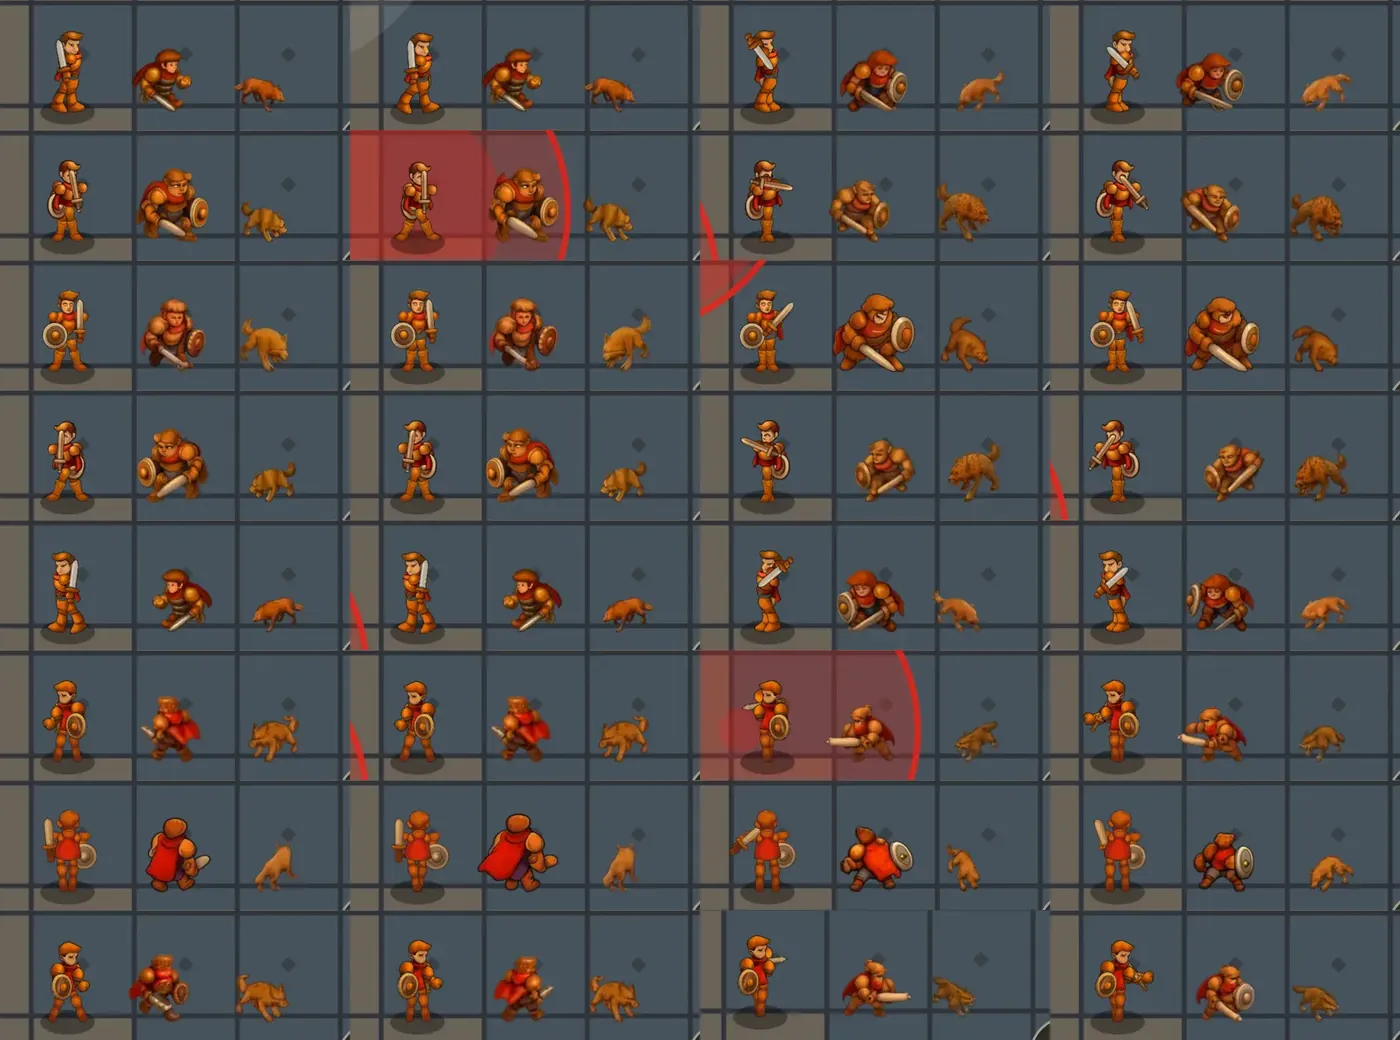
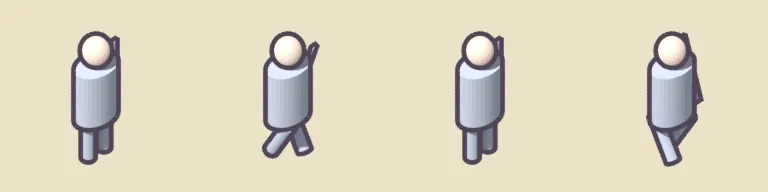
Figuren und Bewegung sind für Jens das A und O. Genau hier ist das Projekt am häufigsten gescheitert. Fünf gemalte Laufproben hintereinander hatten denselben Fehler: Das Bildmodell übernimmt die Beinstellung der Vorlage und wechselt nie das vordere Bein. Es weiß nicht, dass es Bild sieben eines Zyklus malt.
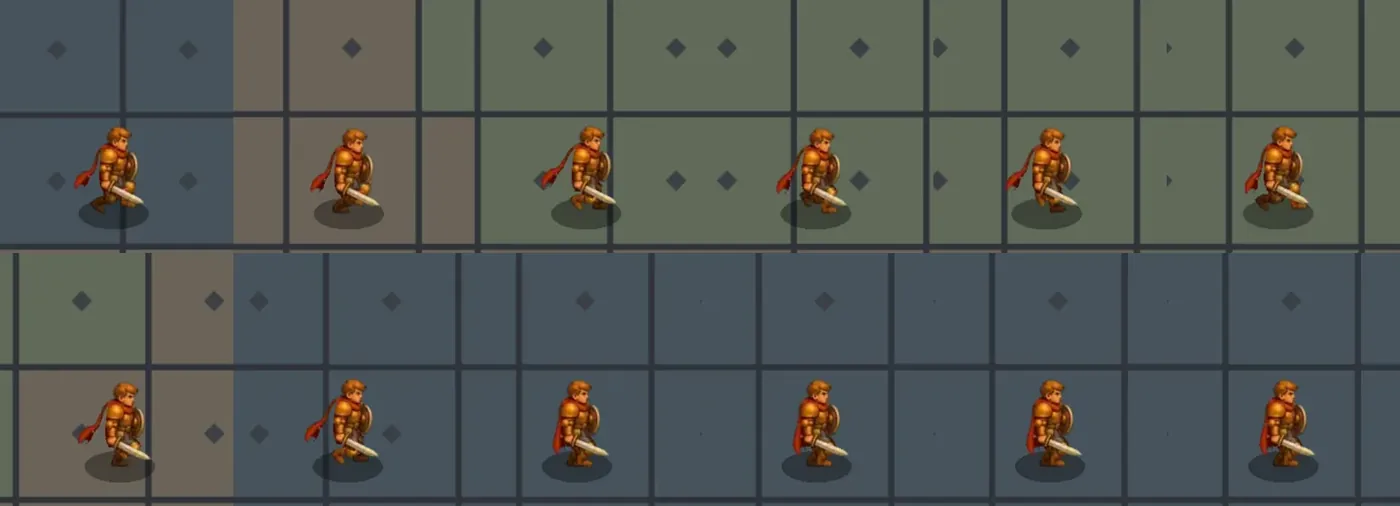
Danach kamen ein Bein-Rig im Code (sauber, aber tänzelnd), Beine per Maskenkorrektur (die Figur springt), eine eigene Lauf-Forschung und ein Rennbogen. Gewonnen hat am 12. Oktober Weg D: Oberkörper gemalt, Beine im Code mit Bewegungskurven aus dem Animationshandwerk, der Umhang als eigenes schwingendes Netz.
Das Zittern lag nicht in den Bildern
Bei allen Laufwegen zitterte die Figur. Die Ursache war die Interpolation: Wenn die Simulation im Hintergrund noch nicht geantwortet hatte, blieb die Figur ein Bild stehen und sprang dann doppelt. Am Desktop mit exakt 16,667 Millisekunden pro Bild war das unsichtbar, auf dem iPhone nicht.
Zwei Kehrtwenden an einem Abend
Nach Tor 2 war klar: Die Gegner mit gemalten Bildfolgen wirken lebendiger als die Helden mit Code-Beinen. Am 21. Oktober um 18:50 sollten deshalb alle Wege getestet werden, auch 3D mit Meshy und Blender und Video über fal.ai. Ein Blender-Test lief bereits. Um 20:40 nahm Jens das zurück: 3D ginge nur für menschenähnliche Figuren, und dann sähen Helden anders aus als alle Wesen. Um 21:11 flog auch die verbesserte Papierpuppe raus. Ab dem 24. Oktober werden Helden Bild für Bild gemalt.
Stimmen, Sounds, Musik
Die erste Stimmprobe mit OpenAI-Stimmen war bis auf eine Aufnahme unbrauchbar. Noch am selben Morgen fiel die Entscheidung für ElevenLabs. Seitdem erzeugt eine eigene Pipeline Sprache mit Regieanweisungen, Soundeffekte und Musik nach einem Kompositionsplan.
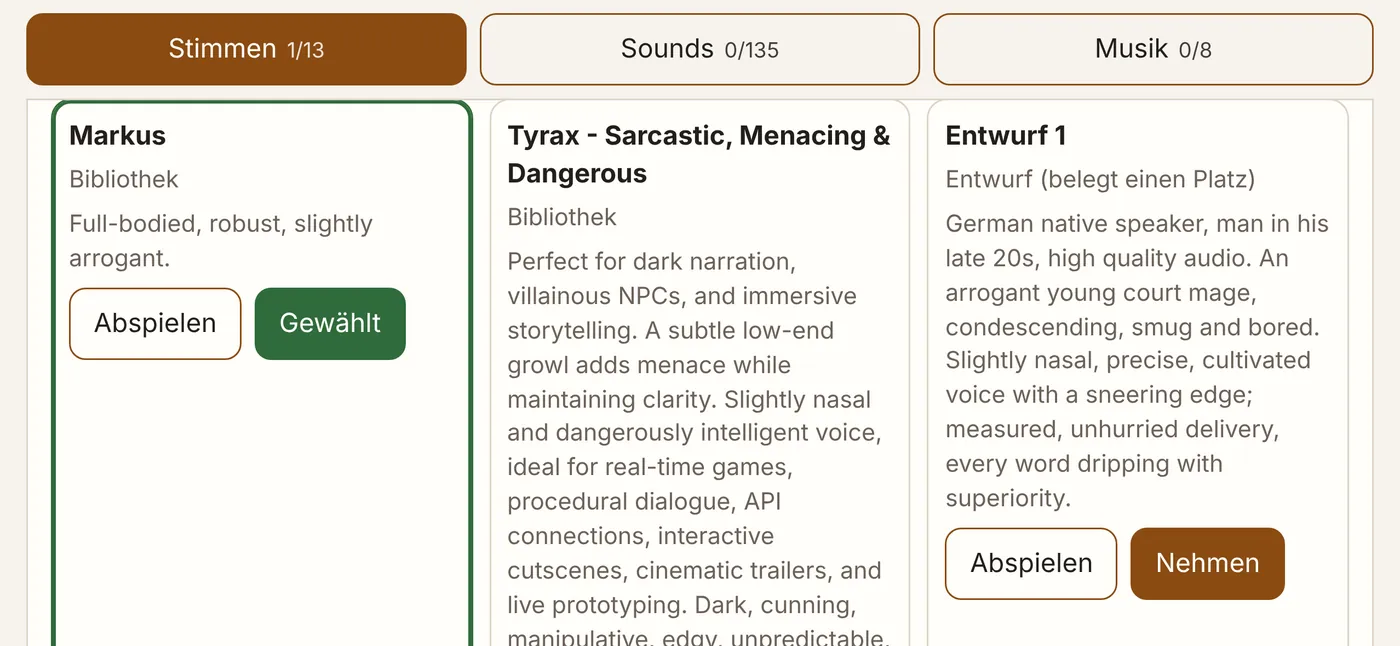
Zum Auswählen gibt es eine Casting-Seite hinter dem Login des Spiels: je Figur drei bis fünf Kandidaten zum Antippen. Ein erster Versuch als Claude-Artifact lud am Handy unzuverlässig und wurde ersetzt. Am Abend des 18. Oktober waren 13 Stimmen, 129 Sounds und 8 Musikstücke gewählt.
Eine Simulation, drei Orte
Die Spiellogik läuft mit festen 20 Takten pro Sekunde, gezeichnet wird mit 60 Bildern und Interpolation dazwischen. Dieselbe Simulation läuft im Web Worker auf dem Handy, im Durable Object auf dem Server und in Node für Tests, Bots und Balancing. Ein Architekturtest verbietet ihr jeden Import aus Grafik, DOM oder Cloudflare.
Ein früher Messbefund: Sinus und Arkustangens rechnen in V8 und JavaScriptCore nicht bitgleich. Statt eigener Mathematik gilt deshalb: je Engine deterministisch, Abgleich nur über gerundete Server-Zustände. Im Koop ist der Server maßgeblich; das Handy sagt nur die eigene Bewegung voraus.
Der Unterbau
TypeScript, Vite und PixiJS v8 im Browser, HUD und Menüs als normales DOM. Ein Cloudflare Worker liefert das Spiel aus und spricht mit einem Durable Object je Welt; Konten und Helden liegen in D1, der Login läuft über Cloudflare Access. Jeder Push auf main wird automatisch gebaut und ausgeliefert – die KI selbst darf nie direkt deployen.
Der Stack stammt aus Star Slayer, dem Vorgängerprojekt. Claudes erster Plan sah Phaser vor. Als Jens das Setup von Star Slayer wollte, schlug Claude selbst den Wechsel vor, um die erprobten Bausteine fürs iPhone weiterzuverwenden: Joystick, Audio, Grafik-Pipeline, Reparaturen für die installierte App.
Friedhof
Ansätze, die gebaut, geprüft und wieder begraben wurden. Jeder hat etwas hinterlassen.
- Das Raster, das keiner hielt 10. Okt. 2026
Animationsbögen als 4×4-Raster mit dem günstigsten Bildmodell.
Warum gescheitert: Figuren größer als ihre Zelle, Nachbarn ragen hinein; beim Helden waren 73 von 80 Zellen angeschnitten.
Was blieb: Kleinere Raster, Referenzbilder und ein Zuschnitt je Figur statt starrer Zellen.
- Die verlorene Schicht 11. Okt. 2026
Bauteams committeten nur lokal in ihrer Arbeitskopie.
Warum gescheitert: Der Container wurde nach der Schicht verworfen. Vier fertige Pakete, ein halbes fünftes und ein Grafik-Antrag waren weg.
Was blieb: Push nach jedem Commit – seitdem Pflichtsatz in jedem Auftrag.
- Finale Bilder, die nie ankamen 11. Okt. 2026
Hochwertige Bilder synchron über die Cloud-Umgebung anfordern.
Warum gescheitert: Alle zehn Anfragen brachen nach rund 30 Sekunden mit HTTP 502 ab – berechnet wurden sie vermutlich trotzdem.
Was blieb: Streaming mit Teilbildern, Stopp nach zwei Fehlern, Abgleich des Kostenbuchs mit dem Dashboard.
- Fünf Laufproben, ein Fehler 11. Okt. 2026
Den Laufzyklus des Helden komplett malen lassen, mit immer besseren Posen-Vorlagen.
Warum gescheitert: Das Bildmodell übernahm in allen fünf Proben die Beinstellung der Vorlage. Das vordere Bein wechselte nie.
Was blieb: Bildmodelle wissen nicht, dass sie Bild sieben eines Zyklus malen. Bewegung muss anders entstehen.
- Beine per Maske 12. Okt. 2026
Nur die Beine in jedem Laufbild neu malen lassen.
Warum gescheitert: Die Figur springt sichtbar von Bild zu Bild.
Was blieb: Nachträgliches Übermalen hält keine zeitliche Linie.
- Das tänzelnde Bein-Rig 12. Okt. 2026
Beine als bewegliche Teile im Code, Rest gemalt.
Warum gescheitert: Technisch sauber, aber es sah aus, als würde der Held tänzeln.
Was blieb: Ohne echte Bewegungskurven wirkt Code-Animation mechanisch – das führte zu Weg D.
- Zittern bei jedem Laufweg 12. Okt. 2026
Die Darstellung wartete auf die Antwort der Simulation im Hintergrund.
Warum gescheitert: Kam die Antwort ein Bild zu spät, stand die Figur still und sprang dann doppelt. Am Desktop unsichtbar, am iPhone deutlich.
Was blieb: Die Darstellung rechnet jetzt mit der letzten Geschwindigkeit weiter. Und: nur echte Geräte sagen die Wahrheit.
- Vom eigenen Filter ausgesperrt 17. Okt. 2026
Testwerte an neue Budgetgrenzen anpassen, die Jens gesetzt hatte.
Warum gescheitert: Der Sicherheitsfilter hielt das für das Entfernen von Sicherheitstests und blockierte danach alle Befehle. Zwei Schichten brachen ab,
mainblieb rot.Was blieb: Budget-Tests lesen ihre Grenzen jetzt aus dem Steuerpult. Bei einer Filter-Ablehnung wird nicht abgebrochen, sondern Jens gefragt.
- Vier Teams, vier Kerne 17. Okt. 2026
So viele Bauteams parallel wie möglich.
Warum gescheitert: Last bis 30, Tests nur noch durch Zeitüberschreitung rot. Eine Schicht: 254 Minuten, ein Paket.
Was blieb: Höchstens drei, Standard zwei Teams; Sperren für Rechen- und Klicktest-Plätze.
- Die leere Nebenschicht 17. Okt. 2026
Eine zweite Schicht parallel zur Hauptschicht.
Warum gescheitert: Sie fand oft kein freies Paket, zählte aber gegen das Wochenlimit. Beide Schichten stritten sich um dieselbe Paketliste.
Was blieb: Eigener Vorrat für Platz B, eigene Reservierungsdatei – und vorerst wieder nur eine Schicht.
- Die Stoppuhr im Container 18. Okt. 2026
Bildzeit im Container als harte Abnahmegrenze.
Warum gescheitert: Ohne Grafikkarte maß der Test die Last der Maschine: gleicher Code, 8 bis 119 Millisekunden, 14 von 57 Läufen grün.
Was blieb: Vier Messebenen statt einer Stoppuhr, echte Geräte für die echte Bildrate.
- Stimmen von der Stange 18. Okt. 2026
Sprachproben für drei Klassen und einen Erzähler mit OpenAI-Stimmen.
Warum gescheitert: Bis auf eine Aufnahme unbrauchbar.
Was blieb: Wechsel zu ElevenLabs für Sprache, Sounds und Musik – am selben Morgen.
- Zwei Kassen, ein Konto 18. Okt. 2026
Mehrere Audio-Teams parallel, jedes mit eigenem Kostenbuch.
Warum gescheitert: Jedes Team sah nur seine eigenen Ausgaben; Musik wurde mehr als doppelt so hoch gebucht, wie sie wirklich kostete.
Was blieb: Bezahlte Läufe nur nacheinander, Kostenbücher werden beim Zusammenführen vereint.
- Die riesige Wolke 20. Okt. 2026
Flächenzauber als große gemalte Effekt-Wolken.
Warum gescheitert: An Tor 2 zu präsent und ohne Eleganz. Geschosse waren gar nicht zu sehen – Treffer kamen ohne Flug.
Was blieb: Effekte in Schichten: Kern, Schweif, Ringwelle, Funken, Bodenfleck. Jeder Schuss fliegt sichtbar, Meteore fallen als einzelne Brocken.
- Die Helfer, die keiner rief 20. Okt. 2026
Kleine, günstige Agenten fürs Suchen und Log-Lesen.
Warum gescheitert: Praktisch nie aufgerufen – sie machten 0,1 Prozent der Tokens aus.
Was blieb: Ein Pflichtsatz in jedem Auftrag. Empfehlungen allein reichen bei KI-Agenten nicht.
- 3D und Video 21. Okt. 2026
Animation über 3D-Modelle (Meshy und Blender) oder über Video-Modelle.
Warum gescheitert: Nach zwei Stunden zurückgenommen: 3D ginge nur für menschenähnliche Figuren und würde den Malstil spalten. Nebenbei stellte sich heraus, dass OpenAI seine Video-Schnittstelle Ende September abgeschaltet hatte.
Was blieb: Ein einheitlicher Malstil wiegt schwerer als technische Eleganz.